跳转至

Boyer–Moore 算法

本章節內容需要以 《前綴函數與 KMP 算法》 作為前置章節。

之前的 KMP 算法將前綴匹配的信息用到了極致,

而 BM 算法背後的基本思想是通過後綴匹配獲得比前綴匹配更多的信息來實現更快的字符跳轉。

引入

想象一下,如果我們的的模式字符串 \(pat\),被放在文本字符串 \(string\) 的左手起頭部,使它們的第一個字符對齊。

\[ \begin{aligned} \textit{pat}:\qquad\qquad &\texttt{EXAMPLE} \\ \textit{string}:\qquad\quad &\texttt{HERE IS A SIMPLE EXAMPLE} \dots \\ &\qquad\ \ \ \, \, \Uparrow \end{aligned} \]

在這裏做定義,往後不贅述:

\(pat\) 的長度為 \(patlen\),特別地對於從 0 開始的串來説,規定 \(patlastpos=patlen-1\) 為 \(pat\) 串最後一個字符的位置;

\(string\) 的長度 \(stringlen\),\(stringlastpos = stringlen-1\)。

假如我們知道了 \(string\) 的第 \(patlen\) 個字符 \(char\)(與 \(pat\) 的最後一個字符對齊)考慮我們能得到什麼信息:

觀察 1

如果我們知道 \(char\) 這個字符不在 \(pat\) 中,我們就不用考慮 \(pat\) 從 \(string\) 的第 \(1\) 個、第 \(2\) 個……第 \(patlen\) 個字符起出現的情況,,而可以直接將 \(pat\) 向下滑動 \(patlen\) 個字符。

觀察 2

更一般地,如果出現在 \(pat\) 最末尾(也就是最右邊)的那一個 \(char\) 字符的位置是離末尾端差了 \(delta_1\) 個字符,

那麼就可以不用匹配,直接將 \(pat\) 向後滑動 \(delta_1\) 個字符:如果滑動距離少於 \(delta_1\),那麼僅就 \(char\) 這個字符就無法被匹配,當然模式字符串 \(pat\) 也就不會被匹配。

因此除非 \(char\) 字符可以和 \(pat\) 末尾的那個字符匹配,否則 \(string\) 要跳過 \(delta_1\) 個字符(相當於 \(pat\) 向後滑動了 \(delta_1\) 個字符)。並且我們可以得到一個計算 \(delta_1\) 的函數 \(delta_1(char)\):

\[ \begin{array}{ll} \textbf{int}\ delta1(\textbf{char}\ char) \\ \qquad \textbf{if}\ \text{char不在pat中 || char是pat上最後一個字符} \\ \qquad\qquad\textbf{return}\ patlen \\ \qquad \textbf{else} \\ \qquad\qquad\textbf{return}\ patlastpos-i\quad\textbf{//}\ \text{i為出現在pat最末尾的那一個char出現的位置,即pat[i]=char} \end{array} \]

注意:顯然這個表只需計算到 \(patlastpos-1\) 的位置

現在假設 \(char\) 和 \(pat\) 最後一個字符匹配到了,那我們就看看 \(char\) 前一個字符和 \(pat\) 的倒數第二個字符是否匹配:

如果是,就繼續回退直到整個模式串 \(pat\) 完成匹配(這時我們就在 \(string\) 上成功得到了一個 \(pat\) 的匹配);

或者,我們也可能會在匹配完 \(pat\) 的倒數第 \(m\) 個字符後,在倒數第 \(m+1\) 個字符上失配,這時我們就希望把 \(pat\) 向後滑動到下一個可能會實現匹配的位置,當然我們希望滑動得越遠越好。

觀察 3(a)

在 觀察 2 中提到,當匹配完 \(pat\) 的倒數 \(m\) 個字符後,如果在倒數第 \(m+1\) 個字符失配,為了使得 \(string\) 中的失配字符與 \(pat\) 上對應字符對齊,

需要把 \(pat\) 向後滑動 \(k\) 個字符,也就是説我們應該把注意力看向之後的 \(k+m\) 個字符(也就是看向 \(pat\) 滑動 k 之後,末段與 \(string\) 對齊的那個字符)。

而 \(k=delta_1-m\),

所以我們的注意力應該沿着 \(string\) 向後跳 \(delta_1-m+m = delta_1\) 個字符。

然而,我們有機會跳過更多的字符,請繼續看下去。

觀察 3(b)

如果我們知道 \(string\) 接下來的 \(m\) 個字符和 \(pat\) 的最後 \(m\) 個字符匹配,假設這個子串為 \(subpat\),

我們還知道在 \(string\) 失配字符 \(char\) 後面是與 \(subpat\) 相匹配的子串,而假如 \(pat\) 對應失配字符前面存在 \(subpat\),我們可以將 \(pat\) 向下滑動一段距離,

使得失配字符 \(char\) 在 \(pat\) 上對應的字符前面出現的 \(subpat\)(合理重現,plausible reoccurrence,以下也簡稱 pr)與 \(string\) 的 \(subpat\) 對齊。如果 \(pat\) 上有多個 \(subpat\),按照從右到左的後綴匹配順序,取第一個(rightmost plausible reoccurrence,以下也簡稱 rpr)。

假設此時 \(pat\) 向下滑動的 \(k\) 個字符(也即 \(pat\) 末尾端的 \(subpat\) 與其最右邊的合理重現的距離),這樣我們的注意力應該沿着 \(string\) 向後滑動 \(k+m\) 個字符,這段距離我們稱之為 \(delta_2(j)\):

假定 \(rpr(j)\) 為 \(subpat=pat[j+1\dots patlastpos]\) 在 \(pat[j]\) 上失配時的最右邊合理重現的位置,\(rpr(j) < j\)(這裏只給出簡單定義,在下文的算法設計章節裏會有更精確的討論),那麼顯然 \(k=j-rpr(j),\ m=patlastpos-j\)。

所以有:

\[ \begin{array}{ll} \textbf{int}\ delta2(\textbf{int}\ j) \quad\textbf{//}\ \text{j為失配字符在pat上對應字符的位置} \\ \qquad\qquad\textbf{return}\ patlastpos-rpr(j) \\ \end{array} \]

於是我們在失配時,可以把把 \(string\) 上的注意力往後跳過 \(\max(delta_1,delta_2)\) 個字符

過程

箭頭指向失配字符 \(char\):

\[ \begin{aligned} \textit{pat}:\qquad\qquad &\texttt{AT-THAT} \\ \textit{string}:\ \ \ \dots\ &\texttt{WHICH-FINALLY-HALTS.--AT-THAT-POINT} \dots \\ &\qquad\ \ \ \, \, \Uparrow \end{aligned} \]

\(\texttt{F}\) 沒有出現 \(pat\) 中,根據 觀察 1,\(pat\) 直接向下移動 \(patlen\) 個字符,也就是 7 個字符:

\[ \begin{aligned} \textit{pat}:\qquad\qquad &\qquad\quad\ \ \, \texttt{AT-THAT} \\ \textit{string}:\ \ \ \dots\ &\texttt{WHICH-FINALLY-HALTS.--AT-THAT-POINT} \dots \\ &\qquad\ \ \ \, \, \qquad\quad\ \ \ \Uparrow \end{aligned} \]

根據 觀察 2,我們需要將 \(pat\) 向下移動 4 個字符使得短橫線字符對齊:

\[ \begin{aligned} \textit{pat}:\qquad\qquad &\qquad\qquad\quad\ \ \, \texttt{AT-THAT} \\ \textit{string}:\ \ \ \dots\ &\texttt{WHICH-FINALLY-HALTS.--AT-THAT-POINT} \dots \\ &\qquad\ \ \ \; \qquad\qquad\qquad \Uparrow \end{aligned} \]

現在char:\(\texttt{T}\) 匹配了,把 \(string\) 上的指針左移一步繼續匹配:

\[ \begin{aligned} \textit{pat}:\qquad\qquad &\qquad\qquad\quad\ \ \, \texttt{AT-THAT} \\ \textit{string}:\ \ \ \dots\ &\texttt{WHICH-FINALLY-HALTS.--AT-THAT-POINT} \dots \\ &\qquad\ \ \ \; \qquad\qquad\quad\ \, \Uparrow \end{aligned} \]

根據 觀察 3(a),\(\texttt{L}\) 失配,因為 \(\texttt{L}\) 不在 \(pat\) 中,所以 \(pat\) 向下移動 \(k=delta_1-m=7-1=6\) 個字符,而 \(string\) 上指針向下移動 \(delta_1=7\) 個字符:

\[ \begin{aligned} \textit{pat}:\qquad\qquad &\qquad\qquad\qquad\qquad\ \ \,\, \texttt{AT-THAT} \\ \textit{string}:\ \ \ \dots\ &\texttt{WHICH-FINALLY-HALTS.--AT-THAT-POINT} \dots \\ &\qquad\ \ \ \; \qquad\qquad\qquad\qquad\ \ \ \, \, \Uparrow \end{aligned} \]

這時 \(char\) 又一次匹配到了 \(pat\) 的最後一個字符 \(\texttt{T}\),\(string\) 上的指針向左匹配,匹配到了 \(\texttt{A}\),繼續向左匹配,發現在字符 \(\texttt{-}\) 失配:

\[ \begin{aligned} \textit{pat}:\qquad\qquad &\qquad\qquad\qquad\qquad\ \ \,\, \texttt{AT-THAT} \\ \textit{string}:\ \ \ \dots\ &\texttt{WHICH-FINALLY-HALTS.--AT-THAT-POINT} \dots \\ &\qquad\ \ \ \; \qquad\qquad\qquad\quad\ \ \ \,\, \Uparrow \end{aligned} \]

顯然直觀上看,此時根據 觀察 3(b),將 \(pat\) 向下移動 \(k=5\) 個字符,使得後綴 \(\texttt{AT}\) 對齊,這種滑動可以獲得 \(string\) 指針最大的滑動距離,此時 \(delta_2=k+patlastpos-j=5+6-4=7\),即 \(string\) 上指針向下滑動 7 個字符。

而從形式化邏輯看,此時,\(delta_1=7-1-2=4,\ delta_2=7, \max(delta_1,delta_2)= 7\), 這樣從形式邏輯上支持了進行 觀察 3(b) 的跳轉:

\[ \begin{aligned} \textit{pat}:\qquad\qquad &\qquad\qquad\qquad\qquad\qquad\quad \;\, \texttt{AT-THAT} \\ \textit{string}:\ \ \ \dots\ &\texttt{WHICH-FINALLY-HALTS.--AT-THAT-POINT} \dots \\ &\qquad\ \ \ \; \qquad\qquad\qquad\qquad\qquad\quad \ \ \; \Uparrow \end{aligned} \]

現在我們發現了 \(pat\) 上每一個字符都和 \(string\) 上對應的字符相等,我們在 \(string\) 上找到了一個 \(pat\) 的匹配。而我們只花費了 14 次對 \(string\) 的引用,其中 7 次是完成一個成功的匹配所必需的比較次數(\(patlen=7\)),另外 7 次讓我們跳過了 22 個字符,Amazing(浮誇口氣)!

算法設計

最初的匹配算法

解釋

現在看這樣一個利用 \(delta_1\) 和 \(delta_2\) 進行字符串匹配的算法:

\[ \begin{array}{ll} i \gets patlastpos. \\ j \gets patlastpos. \\ \textbf{loop}\\ \qquad \textbf{if}\ j < 0 \\ \qquad \qquad \textbf{return}\ i+1 \\ \\ \qquad \textbf{if}\ string[i]=pat[j] \\ \qquad \qquad j \gets j-1 \\ \qquad \qquad i \gets i-1 \\ \qquad \qquad \textbf{continue} \\ \\ \qquad i \gets i+max(delta_1(string[i]), delta_2(j)) \\ \\ \qquad \textbf{if}\ i > stringlastpos \\ \qquad \qquad \textbf{return}\ false \\ \qquad j \gets patlastpos \\ \end{array} \]

如果上面的算法 \(\textbf{return}\ false\),表明 \(pat\) 不在 \(string\) 中;如果返回一個數字,表示 \(pat\) 在 \(string\) 左起第一次出現的位置。

然後讓我們更精細地描述下計算 \(delta_2\),所依靠的 \(rpr(j)\) 函數。

根據前文定義,\(rpr(j)\) 表示在 \(pat(j)\) 失配時,子串 \(subpat=pat[j+1\dots patlastpos]\) 在 \(pat[j]\) 最右邊合理重現的位置。

也就是説需要找到一個最好的 \(k\), 使得 \(pat[k\dots k+patlastpos-j-1]=pat[j+1\dots patlastpos]\),另外要考慮兩種特殊情況:

  1. 當 \(k<0\) 時,相當於在 \(pat\) 前面補充了一段虛擬的前綴,實際上也符合 \(delta_2\) 跳轉的原理。
  2. 當 \(k>0\) 時,如果 \(pat[k-1]=pat[j]\),則這個 \(pat[k\dots k+patlastpos-j-1]\) 不能作為 \(subpat\) 的合理重現。 原因是 \(pat[j]\) 本身是失配字符,所以 \(pat\) 向下滑動 \(k\) 個字符後,在後綴匹配過程中仍然會在 \(pat[k-1]\) 處失配。

還要注意兩個限制條件:

  1. \(k < j\)。因為當 \(k=j\) 時,有 \(pat[k]=pat[j]\),在 \(pat[j]\) 上失配的字符也會在 \(pat[k]\) 上失配。
  2. 考慮到 \(delta_2(patlastpos)= 0\),所以規定 \(rpr(patlastpos) = patlastpos\)。

過程

由於理解 \(rpr(j)\) 是實現 BoyerMoore 算法的核心,所以我們使用如下兩個例子進行詳細説明:

\[ \begin{aligned} \textit{j}:\qquad\qquad\quad\ \ &\texttt{0 1 2 3 4 5 6 7 8} \\ \textit{pat}:\qquad\qquad\ \ &\texttt{A B C X X X A B C} \\ \textit{rpr(j)}:\qquad\quad\ \ &\texttt{5 4 3 2 1 0 2 1 8} \\ \textit{sgn}:\qquad\qquad\ \ &\texttt{- - - - - - - - +} \end{aligned} \]

對於 \(rpr(0)\),\(subpat\) 為 \(\texttt{BCXXXABC}\),在 \(pat[0]\) 之前的最右邊合理重現只能是 \(\texttt{[(BCXXX)ABC]XXXABC}\),也就是最右邊合理重現位置為 -5,即 \(rpr(j)=-5\);

對於 \(rpr(1)\),\(subpat\) 為 \(\texttt{CXXXABC}\),在 \(pat[1]\) 之前的最右邊的合理重現是 \(\texttt{[(CXXX)ABC]XXXABC}\),所以 \(rpr(j)=-4\);

對於 \(rpr(2)\),\(subpat\) 為 \(\texttt{XXXABC}\),在 \(pat[2]\) 之前的最右邊的合理重現是 \(\texttt{[(XXX)ABC]XXXABC}\),所以 \(rpr(j)=-3\);

對於 \(rpr(3)\),\(subpat\) 為 \(\texttt{XXABC}\),在 \(pat[3]\) 之前的最右邊的合理重現是 \(\texttt{[(XX)ABC]XXXABC}\),所以 \(rpr(j)=-2\);

對於 \(rpr(4)\),\(subpat\) 為 \(\texttt{XABC}\),在 \(pat[4]\) 之前的最右邊的合理重現是 \(\texttt{[(X)ABC]XXXABC}\),所以 \(rpr(j)=-1\);

對於 \(rpr(5)\),\(subpat\) 為 \(\texttt{ABC}\),在 \(pat[5]\) 之前的最右邊的合理重現是 \(\texttt{[ABC]XXXABC}\),所以 \(rpr(j)=0\);

對於 \(rpr(6)\),\(subpat\) 為 \(\texttt{BC}\),又因為 \(string[0]=string[6]\),即 \(string[0]\) 等於失配字符 \(string[6]\),所以 \(string[0\dots 2]\) 並不是符合條件的 \(subpat\) 的合理重現,所以在最右邊的合理重現是 \(\texttt{[(BC)]ABCXXXABC}\),所以 \(rpr(j)=-2\);

對於 \(rpr(7)\),\(subpat\) 為 \(\texttt{C}\),同理又因為 \(string[7]=string[1]\),所以 \(string[1\dots 2]\) 並不是符合條件的 \(subpat\) 的合理重現,在最右邊的合理重現是 \(\texttt{[(C)]ABCXXXABC}\),所以 \(rpr(j)=-1\);

對於 \(rpr(8)\),根據 \(delta_2\) 定義,\(rpr(patlastpos)=patlastpos\),得到 \(rpr(8)=8\)。

現在再看一下另一個例子:

\[ \begin{aligned} \textit{j}:\qquad\qquad\quad\ \ &\texttt{0 1 2 3 4 5 6 7 8} \\ \textit{pat}:\qquad\qquad\ \ &\texttt{A B Y X C D E Y X} \\ \textit{rpr(j)}:\qquad\quad\ \ &\texttt{8 7 6 5 4 3 2 1 8} \\ \textit{sgn}:\qquad\qquad\ \ &\texttt{- - - - - - + - +} \end{aligned} \]

對於 \(rpr(0)\),\(subpat\) 為 \(\texttt{BYXCDEYX}\),在 \(pat[0]\) 之前的最右邊合理重現只能是 \(\texttt{[(BYXCDEYX)]ABYXCDEYX}\),也就是最右邊合理重現位置為 -8,即 \(rpr(j)=-8\);

對於 \(rpr(1)\),\(subpat\) 為 \(\texttt{YXCDEYX}\),在 \(pat[1]\) 之前的最右邊合理重現只能是 \(\texttt{[(YXCDEYX)]ABYXCDEYX}\),\(rpr(j)=-7\);

對於 \(rpr(2)\),\(subpat\) 為 \(\texttt{XCDEYX}\),在 \(pat[2]\) 之前的最右邊合理重現只能是 \(\texttt{[(XCDEYX)]ABYXCDEYX}\),\(rpr(j)=-6\);

對於 \(rpr(3)\),\(subpat\) 為 \(\texttt{CDEYX}\),在 \(pat[3]\) 之前的最右邊合理重現只能是 \(\texttt{[(CDEYX)]ABYXCDEYX}\),\(rpr(j)=-5\);

對於 \(rpr(4)\),\(subpat\) 為 \(\texttt{DEYX}\),在 \(pat[4]\) 之前的最右邊合理重現只能是 \(\texttt{[(DEYX)]ABYXCDEYX}\),\(rpr(j)=-4\);

對於 \(rpr(5)\),\(subpat\) 為 \(\texttt{EYX}\),在 \(pat[5]\) 之前的最右邊合理重現只能是 \(\texttt{[(EYX)]ABYXCDEYX}\),\(rpr(j)=-3\);

對於 \(rpr(6)\),\(subpat\) 為 \(\texttt{YX}\),因為 \(string[2\dots 3]=string[7\dots 8]\) 並且有 \(string[6]\neq string[1]\),所以在 \(pat[6]\) 之前的最右邊的合理重現是 \(\texttt{AB[YX]CDEYX}\),\(rpr(j)=2\);

對於 \(rpr(7)\),\(subpat\) 為 \(\texttt{X}\),雖然 \(string[3]=string[8]\) 但是因為 \(string[2] = string[7]\),所以在 \(pat[7]\) 之前的最右邊的合理重現是 \(\texttt{[X]ABYXCDEYX}\),\(rpr(j)=-1\);

對於 \(rpr(8)\),根據 \(delta_2\) 定義,\(rpr(patlastpos)=patlastpos\),得到 \(rpr(8)=8\)。

對匹配算法的一個改進

最後,實踐過程中考慮到搜索過程中估計有 80% 的時間用在了基於 觀察 1 的跳轉上,也就是 \(string[i]\) 和 \(pat[patlastpos]\) 不匹配,然後跳越整個 \(patlen\) 進行下一次匹配的過程。

於是,可以為此進行特別的優化:

我們定義一個 \(delta0\):

\[ \begin{array}{ll} \textbf{int}\ delta0(\textbf{char}\ char) \\ \qquad \textbf{if}\ char=pat[patlastpos] \\ \qquad\qquad \textbf{return}\ large\ \ \text{// large為一個整數,需要滿足large>stringlastpos+patlen} \\ \qquad \textbf{return}\ delta1(char) \end{array} \]

用 \(delta0\) 代替 \(delta_1\),得到改進後的匹配算法:

\[ \begin{array}{ll} i \gets patlastpos \\ \textbf{loop} \\ \qquad\textbf{if} \ i > stringlastpos \\ \qquad\qquad\textbf{return}\ false\\ \\ \qquad\textbf{while}\ i < stringlen \\ \qquad\qquad i \gets i+delta0(string(i)) \ \ \text{// 除非string[i]和pat末尾字符匹配,否則至多向下滑動patlen }\\\ \qquad\textbf{if}\ i \leqslant\ large \qquad\qquad\qquad\qquad \text{//此時表示string上沒有一個字符和pat末尾字符匹配}\ \\ \qquad\qquad\textbf{return}\ false\\ \\ \qquad i \gets i-large \\ \qquad j \gets patlastpos. \\ \qquad\textbf{while}\ j \geqslant\ 0 \ and \ string[i]=pat[j]\\ \qquad \qquad j \gets j-1 \\ \qquad \qquad i \gets i-1 \\ \\ \qquad \textbf{if}\ j < 0 \\ \qquad \qquad \textbf{return}\ i+1 \\ \qquad i \gets i+max(delta_1(string[i]), delta_2(j)) \\ \\ \end{array} \]

其中 \(large\) 起到多重作用,一是類似後面介紹的 Horspool 算法進行快速的壞字符跳轉,二是輔助檢測字符串搜索是否完成。

經過改進,比起原算法,在做 觀察 1 跳轉時不必每次進行 \(delta_2\) 的多餘計算,使得在通常字符集下搜索字符串的性能有了明顯的提升。

\(delta_2\) 構建細節

引入

説起 \(delta_2\) 的實現,發表在 1977 年 10 月的Communications of the ACM上的在 Boyer、Moor 的論文1裏只描述了這個靜態表,並沒有説明如何產生它。

而構造 \(delta_2\) 的具體實現的討論出現在 1977 年 6 月 Knuth、Morris、Pratt 在SIAM Journal on Computing上正式聯合發表的 KMP 算法的論文2裏(這篇論文是個寶藏,除了 KMP,其中還提及了若干字符串搜索的算法構想和介紹,其中就包括了本文介紹的 BM 算法),聽起來有點兒魔幻,嗯哼?這就不得不稍微介紹一點歷史細節了:

  1. 1969 年夏天 Morris 為某個大型機編寫文本編輯器時利用有限自動機的理論發明了等價於 KMP 算法的字符串匹配算法,而他的算法由於過於複雜,被不理解他算法的同事當做 bug 修改得一團糟,哈哈。

  2. 1970 年 KMP 中的「帶頭人」Knuth 在研究 Cook 的關於兩路確定下推自動機(two-way deterministic pushdown automaton)的理論時受到啓發,也獨立發明了 KMP 算法的雛形,並把它展示給他的同事 Pratt,Pratt 改進了算法的數據結構。

  3. 1974 年 Boyer、Moor 發現通過更快地跳過不可能匹配的文本能實現比 KMP 更快的字符串匹配,(Gosper 也獨立地發現了這一點),而一個只有原始 \(delta_1\) 定義的匹配算法是 BM 算法的最原始版本。

  4. 1975 年 Boyer、Moor 提出了原始的 \(delta_2\) 表,而這個版本的 \(delta_2\) 表不僅不會對性能有所改善,還會在處理小字符表時拖累性能表現,而同年 MIT 人工智能實驗室的 Kuipers 和我們熟悉的 Knuth 向他們提出了類似的關於 \(delta_2\) 的改進建議,於是 Boyer、Moor 在論文的下一次修改中提到了這個建議,並提出一個用二維表代替 \(delta_1\) 和 \(delta_2\) 的想法。

  5. 1976 年 1 月 Knuth 證明了關於 \(delta_2\) 的改進會得到更好的性能,於是 Boyer、Moor 兩人又一次修改了論文,得到了現在版本的 \(delta_2\) 定義。同年 4 月,斯坦福的 Floyd 又發現了 Boyer、Moor 兩人第一版本的公式中的嚴重的統計錯誤,並給出了現在版本的公式。

  6. Standish 又為 Boyer、Moor 提供了現在的匹配算法的改進。

  7. 1977 年 6 月 Knuth、Morris、Pratt 正式聯合發表了 KMP 算法的論文,其中在提及比 KMP 表現更好的算法中提出了 \(delta_2\) 的構建方式。(其中也感謝了 Boyer、Moor 對於證明線性定理(linearity theorem)提供的幫助)

這個 BM 算法的發展的故事,切實地向我們展示了團結、友誼、協作,以及謙虛好學不折不撓「在平凡中實現偉大」!😂😂😂

時間複雜度為 \(O(n^3)\) 的構建 \(delta_2\) 的樸素算法

在介紹 Knuth 的 \(delta_2\) 構建算法之前,根據定義,我們會有一個原始、簡單但有時可能已經夠用的樸素算法(除非你需要構建長度成百上千的 \(pat\)):

  1. 對於 [0, patlen) 區間的每一個位置 i,根據 subpat 的長度確定其重現位置的區間,也就是 [-subpatlen, i];
  2. 可能的重現位置按照從右到左進行逐字符比較,尋找符合 \(delta_2\) 要求的最右邊 \(subpat\) 的重現位置;
  3. 最後別忘了令 \(delta_2(lastpos)= 0\)。
實現
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
use std::cmp::PartialEq;

pub fn build_delta_2_table_naive(p: &[impl PartialEq]) -> Vec<usize> {
    let patlen = p.len();
    let lastpos = patlen - 1;
    let mut delta_2 = vec![];

    for i in 0..patlen {
        let subpatlen = (lastpos - i) as isize;

        if subpatlen == 0 {
            delta_2.push(0);
            break;
        }

        for j in (-subpatlen..(i + 1) as isize).rev() {
            // subpat 匹配
            if (j..j + subpatlen)
            .zip(i + 1..patlen)
            .all(|(rpr_index, subpat_index)| {
                if rpr_index < 0 {
                    return true;
                }

                if p[rpr_index as usize] == p[subpat_index] {
                    return true;
                }

                false
            })
            && (j <= 0 || p[(j - 1) as usize] != p[i])
            {
                delta_2.push((lastpos as isize - j) as usize);
                break;
            }
        }
    }

    delta_2
}

特別地,對 Rust 語言特性進行必要地解釋,下不贅述:

  • usize 和 isize 是和內存指針同字節數的無符號整數和有符號整數,在 32 位機上相當於 u32 和 i32,64 位機上相當於 u64 和 i64。
  • 索引數組、向量、分片時使用 usize 類型的數字(因為在做內存上的隨機訪問並且下標不能為負值),所以如果需要處理負值要用 isize,而進行索引時又要用 usize,這就看到使用 as 關鍵字進行二者之間的顯式轉換。
  • impl PartialEq 只是用作泛型,可以同時支持 Unicode 編碼的 char 和二進制的 u8。

顯見這是個時間複雜度為 \(O(n^3)\) 的暴力算法。

時間複雜度為 \(O(n)\) 的構建 \(delta_2\) 的高效算法

下面我們要介紹的是時間複雜度為 \(O(n)\),但是需要額外 \(O(n)\) 空間複雜度的高效算法。

需要指出的是,雖然 1977 年 Knuth 提出了這個構建方法,然而他的原始版本的構建算法存在一個缺陷,實際上對於某些 \(pat\) 產生不出符合定義的 \(delta_2\)。

Rytter 在 1980 年SIAM Journal on Computing上發表的文章3對此提出了修正,但是 Rytter 的這篇文章在細節上有些令人疑惑的地方,包括不限於:

  • 示例中奇怪的 \(delta_2\) 數值(筆者注:不清楚他依據的 \(delta_2\) 是否和最終版 \(delta_2\) 定義有微妙的差別,但我實在不想因為這事兒繼續考古了😱)
  • 明顯的在複述 Knuth 算法時的筆誤、算法上錯誤的縮進(可能是文章錄入時的問題?)
  • 奇妙的變量命名(考慮到那個時代的標籤:goto 語句、彙編語言、大型機,隨性的變量命名也很合理)

總之就是你絕對不想看他的那個修正算法的具體實現,不過好在他在用文字描述的時候比用偽代碼清晰多了呢,現在我們用更清晰的思路和代碼結構整理這麼一個

\(delta_2\) 的構建算法:

首先考慮到 \(delta_2\) 的定義比較複雜,我們按照 \(subpat\) 的重現位置進行分類,每一類進行單獨處理,這是高效實現的關鍵思路。

按照重現位置由遠到近,也就是偏移量由大到小,分成如下幾類:

  1. 整個 \(subpat\) 重現位置完全在 \(pat\) 左邊的,比如 \(\texttt{[(EYX)]ABYXCDEYX}\),此時 \(delta_2(j) = patlastpos\times 2 - j\);

  2. \(subpat\) 的重現有一部分在 \(pat\) 左邊,有一部分是 \(pat\) 頭部,比如 \(\texttt{[(XX)ABC]XXXABC}\),此時 \(patlastpos < delta_2(j) < patlastpos\times 2 - j\); 我們把 \(subpat\) 完全在 \(pat\) 頭部的的邊際情況也歸類在這裏(當然根據實現也可以歸類在下邊),比如 \(\texttt{[ABC]XXXABC}\),此時 \(patlastpos = delta_2(j)\);

  3. \(subpat\) 的重現完全在 \(pat\) 中,比如 \(\texttt{AB[YX]CDEYX}\),此時 \(delta_2(j) < patlastpos\)。

現在來討論如何高效地計算這三種情況:

第一種情況

這是最簡單的情況,只需一次遍歷並且可以順便將 \(delta_2\) 初始化。

第二種情況

我們觀察什麼時候會出現 \(subpat\) 的重現一部分在 \(pat\) 左邊,一部分是 \(pat\) 的頭部的情況呢?應該是 \(subpat\) 的某個後綴和 \(pat\) 的某個前綴相等,

比如之前的例子:

\[ \begin{aligned} \textit{j}:\qquad\qquad\quad\ \ &\texttt{0 1 2 3 4 5 6 7 8} \\ \textit{pat}:\qquad\qquad\ \ &\texttt{A B C X X X A B C} \\ \end{aligned} \]

\(delta_2(3)\) 的重現 \(\texttt{[(XX)ABC]XXXABC}\),\(subpat\) \(\texttt{XXABC}\) 的後綴與 pat 前綴中,有相等的,是 \(\texttt{ABC}\)。

説到這個拗口的前綴後綴相等,此時看過之前《前綴函數與 KMP 算法》的小夥伴們可能已經有所悟了,

沒錯,實際上對第二種和第三種情況的計算的關鍵都離不開前綴函數的計算和和應用

那麼只要 \(j\) 取值使得 \(subpat\) 包含這個相等的後綴,那麼就可以得到第二種情況的 \(subpat\) 的重現,對於例子,我們只需要使得 \(j \leqslant 5\),

而當 \(j = 5\) 時,就是 \(subpat\) 完全在 \(pat\) 頭部的邊際情況。

可以計算此時的 \(delta_2(j)\):

設此時這對相等的前後綴長度為 \(\textit{prefixlen}\),可知 \(subpatlen = patlastpos - j\),那麼在 \(pat\) 左邊的部分長度是 \(subpatlen-\textit{prefixlen}\),

而 \(rpr(j) = -(subpatlen-\textit{prefixlen})\),所以得到 \(delta_2(j) = patlastpos - rpr(j) = patlastpos \times 2 - j - \textit{prefixlen}\)。

那麼問題到這兒是不是結束了呢,並不是,因為可能會有多對相等的前綴和後綴,比如:

\[ \begin{aligned} \textit{j}:\qquad\qquad\quad\ \ &\texttt{0 1 2 3 4 5 6 7 8 9} \\ \textit{pat}:\qquad\qquad\ \ &\texttt{A B A A B A A B A A} \\ \end{aligned} \]

在 \(j\leq2\) 處有 \(\texttt{ABAABAA}\),\(2< j \leq 5\) 處有 \(\texttt{ABAA}\),在 \(5<j\leq8\) 處有 \(\texttt{A}\)

之前提到的 Knuth 算法的缺陷就是隻考慮了最長的那一對的情況。

所以實際上我們要考慮所有 \(subpat\) 後綴與 \(pat\) 前綴相等的情況,其實也就是計算 \(pat\) 所有真後綴和真前綴相等的情況,然後按照長度從大到小,\(j\) 分區間計算

不同的 \(delta_2(j)\)。而如何得到 \(pat\) 所有相等的真前綴和真後綴長度呢?答案正是利用前綴函數和逆向運用計算前綴函數的狀態轉移方程:\(j^{(n)} = \pi[j^{(n-1)}-1]\)。

從 \(\pi[patlastpos]\) 開始作為最長一對的長度,然後通過逆向運行狀態轉移方程,得到下一個次長相等真前綴和真後綴的長度,直到這裏我們就完成了第二種情況的 \(delta_2\) 的計算。

第三種情況

\(subpat\) 的重現不在別的地方,恰好就在 \(pat\) 中(不包括 \(pat\) 的頭部)。

也就是按照從右到左的順序,在 \(pat[0\dots patlastpos-1]\) 中尋找 \(subpat\)。

開啓腦洞:既然是個字符串搜索的問題,那麼當然可以用著名的 BM 算法本身解決,於是我們就得到了一個 BM 的遞歸實現的第三種情況,結束條件是 \(patlen \leqslant 2\)

而且根據 \(delta_2\) 的定義,找到的 \(subpat\) 的重現的下一個(也就是左邊一個)字符和作為 \(pat\) 後綴的 \(subpat\) 的下一個字符不能一樣。

這就很好地啓發了我們(起碼很好地啓發了 Knuth)使用類似於計算前綴函數的過程計算第三種情況,只不過是左右反過來的前綴函數:

  • 兩個指針分別指向子串的左端點和子串最長公共前後綴的「前綴」位置,從右向左移動,在發現指向的兩個字符相等時繼續移動,此時相當於「前綴」變大;
  • 當兩個字符不相等時,之前相等的部分就滿足了 \(delta_2\) 對重現的要求,並且回退指向「前綴」位置的指針直到構成新的字符相等或者出界。

同前綴函數一樣,需要一個輔助數組,用於回退,可以使用之前計算第二種情況所生成的前綴數組的空間。

上述實現

 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
use std::cmp::PartialEq;
use std::cmp::min;

pub fn build_delta_2_table_improved_minghu6(p: &[impl PartialEq]) -> Vec<usize> {
    let patlen = p.len();
    let lastpos = patlen - 1;
    let mut delta_2 = Vec::with_capacity(patlen);

    // 第一種情況
    // delta_2[j] = lastpos * 2 - j
    for i in 0..patlen {
        delta_2.push(lastpos * 2 - i);
    }

    // 第二種情況
    // lastpos <= delata2[j] = lastpos * 2 - j
    let pi = compute_pi(p);  // 計算前綴函數
    let mut i = lastpos;
    let mut last_i = lastpos; // 只是為了初始化
    while pi[i] > 0 {
        let start;
        let end;

        if i == lastpos {
            start = 0;
        } else {
            start = patlen - pi[last_i];
        }

        end = patlen - pi[i];

        for j in start..end {
            delta_2[j] = lastpos * 2 - j - pi[i];
        }

        last_i = i;
        i = pi[i] - 1;
    }

    // 第三種情況
    // delata2[j] < lastpos
    let mut j = lastpos;
    let mut t = patlen;
    let mut f = pi;
    loop {
        f[j] = t;
        while t < patlen && p[j] != p[t] {
            delta_2[t] = min(delta_2[t], lastpos - 1 - j);  // 使用min函數保證後面可能的回退不會覆蓋前面的數據
            t = f[t];
        }

        t -= 1;
        if j == 0 {
            break;
        }
        j -= 1;
    }

    // 沒有實際意義,只是為了完整定義
    delta_2[lastpos] = 0;

    delta_2
}

Galil 規則對多次匹配時最壞情況的改善

關於後綴匹配算法的多次匹配問題

之前的搜索算法只涉及到在 \(string\) 中尋找第一次 \(pat\) 匹配的情況,而對與在 \(string\) 中尋找全部 \(pat\) 的匹配的情況有很多不同的算法思路,這個問題的核心關注點是:

如何利用之前匹配成功的字符的信息,將最壞情況下的時間複雜度降為線性。

在原始的成功匹配後,簡單的 \(string\) 的指針向後滑動 \(patlen\) 距離後重新開始後綴匹配,這會導致最壞情況下回到 \(O(mn)\) 的時間複雜度(按照慣例,\(m\) 為 \(patlen\),\(n\) 為 \(stringlen\),下同)。

比如一個極端的例子:\(pat\):\(\texttt{AAA}\),\(string\):\(\texttt{AAAAA}\dots\)。

對此 Knuth 提出來的一個方法是用一個「數量有限」的狀態的集合來記錄 \(patlen\) 長度的字符,這種算法保證 \(string\) 上每一個字符最多比較一次,但代價是這個「數量有限」的狀態可能數目並不怎麼「有限」,比如立刻就能想到它的上限是 \(2^{m}\) 個,但並不清楚它到底能變得多大,對於一個字符彼此不相等的 \(pat\),需要 \(\dfrac{1}{2}m^{2}+m\) 個狀態。這個算法思路同在 1977 年 6 月的發表 KMP 論文2裏被介紹,也許在未來某個節點匹配代價很高但狀態存儲代價很低的新場景能重新得到應用,但對於現在簡單的字符串匹配,這個設計並不特別合適。

而 Knuth 提出的另一個方法,嗯這裏就不介紹了,同在上面的 Knuth 那篇「寶藏」論文裏被介紹,缺點是除了過於複雜以外主要是構建輔助的數據結構需要的預處理時間太大:\(O(qm)\)

\(q\) 為全字符集的大小,而且 \(qm\) 前面的係數很大。

於是在這個背景下就有了下面介紹的思路簡單,不需要額外預處理開銷的 Galil 算法4。

Galil 規則

原理很簡單,假定一個 \(pat\),它是某個子串 \(U\) 重複 n 次構成的字符串 \(UUUU\dots\) 的前綴,那麼我們稱 \(U\) 為 \(pat\) 的一個週期。

比如,\(pat: \texttt{ABCABCAB}\),是 \(\texttt{ABC}\) 的重複 \(\texttt{ABCABCABC}\) 的前綴,所以 \(\texttt{ABC}\) 的長度 \(3\) 就是這個 \(pat\) 的週期長度,也即 \(pat\) 滿足 \(pat[i] = pat[i+3]\)。

當然其實 \(\texttt{ABCABC}\dots\) 也是 \(pat\) 的週期,但我們只關注最短的那個。

事實上,廣義地講,\(pat\) 至少擁有一個長度為它自身的週期。

我們規定這個最短的週期為 \(k\),\(k\leq patlen\)。

在搜索過程中,假如我們的 \(pat\) 成功地完成了一次匹配,那麼依照週期的特點,實際上只需將 \(string\) 向後滑動 \(k\) 個字符,比較這 \(k\) 個字符是否對應相等就可以直接判斷是否存在 \(pat\) 的又一個匹配。

而如何計算這個最短週期的長度呢,假如我們知道 \(pat\) 的相等的一對兒前綴 - 後綴,設它們的長度為 \(\textit{prefixlen}\),那麼有 \(pat[i] = pat[i+(patlen-\textit{prefixlen})]\)。

而從數學的角度看這個公式,顯然我們已經有了長度為 \(patlen-\textit{prefixlen}\) 的週期,而當我們知道 \(pat\) 最長的那一對相等的前綴 - 後綴,我們就得到了 \(pat\) 最短的週期。

而這個最長相等的前後綴長度,\(\pi[patlastpos]\),在我們在計算 \(delta_2\) 的時候已經計算過了,所以實際不需要額外的預處理時間和空間,就能改善後綴匹配算法最壞情況的時間複雜度為線性。

結合上述優化的 BM 的搜索算法最終實現

 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
#[cfg(target_pointer_width = "64")]
const LARGE: usize = 10_000_000_000_000_000_000;

#[cfg(not(target_pointer_width = "64"))]
const LARGE: usize = 2_000_000_000;

pub struct BMPattern<'a> {
    pat_bytes: &'a [u8],
    delta_1: [usize; 256],
    delta_2: Vec<usize>,
    k: usize  // pat的最短週期長度
}

impl<'a> BMPattern<'a> {
    // ...

    pub fn find_all(&self, string: &str) -> Vec<usize> {
        let mut result = vec![];
        let string_bytes = string.as_bytes();
        let stringlen = string_bytes.len();
        let patlen = self.pat_bytes.len();
        let pat_last_pos = patlen - 1;
        let mut string_index = pat_last_pos;
        let mut pat_index;
        let l0 =  patlen - self.k;
        let mut l = 0;

        while string_index < stringlen {
            let old_string_index = string_index;

            while string_index < stringlen {
                string_index += self.delta0(string_bytes[string_index]);
            }
            if string_index < LARGE {
                break;
            }

            string_index -= LARGE;

            // 如果string_index發生移動,意味着自從上次成功匹配後發生了至少一次的失敗匹配。
            // 此時需要將Galil規則的二次匹配的偏移量歸零。
            if old_string_index < string_index {
                l = 0;
            }

            pat_index = pat_last_pos;

            while pat_index > l && string_bytes[string_index] == self.pat_bytes[pat_index] {
                string_index -= 1;
                pat_index -= 1;
            }

            if pat_index == l && string_bytes[string_index] == self.pat_bytes[pat_index] {
                result.push(string_index - l);

                string_index += pat_last_pos - l + self.k;
                l = l0;
            } else {
                l = 0;
                string_index += max(
                    self.delta_1[string_bytes[string_index] as usize],
                    self.delta_2[pat_index],
                );
            }
        }

        result
    }
}

最壞情況在實踐中性能影響

從實踐的角度上説,理論上的最壞情況並不容易影響性能表現,哪怕是很小的只有 4 的字符集的隨機文本測試下這種最壞情況的影響也小到難以觀察。

也因此如果沒有很好地設計,使用 Galil 法則會拖累一點平均的性能表現,但對於一些極端特殊的 \(pat\) 和 \(string\) 比如例子中的:\(pat\):\(\texttt{AAA}\),\(string\):\(\texttt{AAAAA}\dots\),Galil 規則的應用確實會使得性能表現提高數倍。

實踐及後續

這個部分要討論實踐中的具體問題。

儘管前面給出了一些算法的實現代碼,但並沒有真正討論過完整實現可能面臨的一些「小問題」。

字符類型的考慮

在英語環境下,特別是上世紀 70 年代那個時候,人們考慮字符,默認的前提是它是 ASCII 碼,通用字符表是容易通過一個固定大小的數組來確定的。\(delta_1\) 的初始化只需要基於這個固定大小的數組。

而在嘗試用 Rust 實現上述算法的時候,第一個遇到的問題是字符的問題,用一門很新的 2010 + 發展起來的語言來實現 1970 + 時代的算法,是一件很有意思的事情。

會觀察到一些因時代發展而產生的一些變化,現代的編程語言,內生的 char 類型就是 Unicode,首先不可能用一個全字符集大小的數組來計算 \(delta_1\),(其實也可以,只是完成一個 UTF-8 編碼的字符串搜索可能需要額外 1GB 內存)但是可以使用哈希表來代替,同樣是 \(O(1)\) 的隨機訪問成本,畢竟哈希表是現代編程語言最基礎的標準件之一了(哪怕是 Go 都有呢)。

但更嚴重的問題是 Unicode 使用的都是變長的字節編碼方案,所以沒辦法直接按照字符個數計算跳轉的字節數,當然,如果限定文本是簡單的 ASCII 字符集,我們仍然可以按照 1 字符寬 1 字節來進行快速跳轉,但這樣的實現根本就沒啥卵用!😠

在思考的過程中,首先的一個想法是直接將字符串轉為按字符索引的向量數組,但這意味着啥都不用做就先有了一個遍歷字符串的時間開銷,和額外的大於等於字符串字節數的額外空間開銷(因為 char 類型是 Unicode 字面值,採用固定 4 字節大小保存)。

於是我改進了思路,對於變長編碼字符串,至少要完全遍歷一遍,才能完成字符串匹配,那麼在遍歷過程中,我使用一個基於可增長的環結構實現的雙頭隊列作為滑動窗口,保存過去 \(patlen\) 個字符,如果當前 \(string\) 的索引小於算法計算的跳轉,就讓循環空轉直到等於算法要求的索引。實踐證明,這個巧妙的設計使得在一般字符上搜索的 BM 算法的實現比暴力匹配算法還要慢一些。😳😳

於是挫折使我困惑,困惑使我思考,終於一束陽光照進了石頭縫裏:

  1. 字符串匹配算法高效的關鍵在於字符索引的快速跳轉
  2. 字符索引一定要建立在等寬字符的基礎上,

基於這兩條原則思考,我就發現二進制字節本身:1 字節等寬、字符全集大小是 256,就是符合條件的完美字符!在這個基礎上完成了一系列後綴匹配算法的高效實現。

Simplified Boyer–Moore 算法

BM 算法最複雜的地方就在於 \(delta_2\) 表(通俗的名字是好後綴表)的構建,而實踐中發現,在一般的字符集上的匹配性能主要依靠 \(delta_1\) 表(通俗的名字是壞字符表),於是出現了僅僅使用 \(delta_1\) 表的簡化版 BM 算法,通常表現和完整版差距很小。

Boyer–Moore–Horspol 算法

Horspol 算法同樣是基於壞字符的規則,不過是在與 \(pat\) 尾部對齊的字符上應用 \(delta_1\),這個效果類似於前文對匹配算法的改進,所以它的通常表現優於原始 BM 和匹配算法改進後的 BM 差不多。

實現
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
pub struct HorspoolPattern<'a> {
    pat_bytes: &'a [u8],
    bm_bc: [usize; 256],
}

impl<'a> HorspoolPattern<'a> {
    // ...
    pub fn find_all(&self, string: &str) -> Vec<usize> {
        let mut result = vec![];
        let string_bytes = string.as_bytes();
        let stringlen = string_bytes.len();
        let pat_last_pos = self.pat_bytes.len() - 1;
        let mut string_index = pat_last_pos;

        while string_index < stringlen {
            if &string_bytes[string_index-pat_last_pos..string_index+1] == self.pat_bytes {
                result.push(string_index-pat_last_pos);
            }

            string_index += self.bm_bc[string_bytes[string_index] as usize];
        }

        result
    }
}

Boyer–Moore–Sunday 算法

Sunday 算法同樣是利用壞字符規則,只不過相比 Horspool 它更進一步,直接關注 \(pat\) 尾部對齊的那個字符的下一個字符。

實現它只需要稍微修改一下 \(delta_1\) 表,使得它相當於在 \(patlen+1\) 長度的 \(pat\) 上進行構建。

Sunday 算法通常用作一般情況下實現最簡單而且平均表現最好之一的實用算法,通常表現比 Horspool、BM 都要快一點。

實現
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
pub struct SundayPattern<'a> {
    pat_bytes: &'a [u8],
    sunday_bc: [usize; 256],
}

impl<'a> SundayPattern<'a> {
    // ...
    fn build_sunday_bc(p: &'a [u8]) -> [usize; 256] {
        let mut sunday_bc_table = [p.len() + 1; 256];

        for i in 0..p.len() {
            sunday_bc_table[p[i] as usize] = p.len() - i;
        }

        sunday_bc_table
    }

    pub fn find_all(&self, string: &str) -> Vec<usize> {
        let mut result = vec![];
        let string_bytes = string.as_bytes();
        let pat_last_pos = self.pat_bytes.len() - 1;
        let stringlen = string_bytes.len();
        let mut string_index = pat_last_pos;

        while string_index < stringlen {
            if &string_bytes[string_index - pat_last_pos..string_index+1] == self.pat_bytes {
                result.push(string_index - pat_last_pos);
            }

            if string_index + 1 == stringlen {
                break;
            }

            string_index += self.sunday_bc[string_bytes[string_index + 1] as usize];
        }

        result
    }
}

BMHBNFS 算法

該算法結合了 Horspool 和 Sunday,是 CPython 實現 stringlib 模塊時用到的 find 的算法5,似乎國內更有名氣,不清楚為何叫這個名字,怎麼就「AKA」了?

以下簡稱 B5S。

B5S 基本想法是:

  1. 按照後綴匹配的思路,首先比較 \(patlastpos\) 位置對應的字符是否相等,如果相等就比較 \(0\dots patlastpos-1\) 對應位置的字符是否相等,如果仍然相等,那麼就發現一個匹配;

  2. 如果任何一個階段發生不匹配,就進入跳轉階段;

  3. 在跳轉階段,首先觀察 \(patlastpos\) 位置的下一個字符是否在 \(pat\) 中,如果不在,直接向右滑動 \(patlen+1\),這是 Sunday 算法的最大利用;

    如果這個字符在 \(pat\) 中,對 \(patlastpos\) 處的字符利用 \(delta_1\) 進行 Horspool 跳轉。

而這個算法根據時間節省還是空間節省為第一目標,會有差別巨大的不同實現。

時間節省版本

實現
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
pub struct B5STimePattern<'a> {
    pat_bytes: &'a [u8],
    alphabet: [bool;256],
    bm_bc: [usize;256],
    k: usize
}

impl<'a> B5STimePattern<'a> {
    pub fn new(pat: &'a str) -> Self {
        assert_ne!(pat.len(), 0);

        let pat_bytes = pat.as_bytes();
        let (alphabet, bm_bc, k) = B5STimePattern::build(pat_bytes);

        B5STimePattern { pat_bytes, alphabet, bm_bc, k }
    }

    fn build(p: &'a [u8]) -> ([bool;256], [usize;256], usize)  {
        let mut alphabet = [false;256];
        let mut bm_bc = [p.len(); 256];
        let lastpos = p.len() - 1;

        for i in 0..lastpos {
            alphabet[p[i] as usize] = true;
            bm_bc[p[i] as usize] = lastpos - i;
        }

        alphabet[p[lastpos] as usize] = true;

        (alphabet, bm_bc, compute_k(p))
    }

    pub fn find_all(&self, string: &str) -> Vec<usize> {
        let mut result = vec![];
        let string_bytes = string.as_bytes();
        let pat_last_pos = self.pat_bytes.len() - 1;
        let patlen = self.pat_bytes.len();
        let stringlen = string_bytes.len();
        let mut string_index = pat_last_pos;
        let mut offset = pat_last_pos;
        let offset0 = self.k - 1;

        while string_index < stringlen {
            if string_bytes[string_index] == self.pat_bytes[pat_last_pos] {
                if &string_bytes[string_index-offset..string_index] == &self.pat_bytes[pat_last_pos-offset..pat_last_pos] {
                    result.push(string_index-pat_last_pos);

                    offset = offset0;

                    // Galil rule
                    string_index += self.k;
                    continue;
                }
            }

            if string_index + 1 == stringlen {
                break;
            }

            offset = pat_last_pos;

            if !self.alphabet[string_bytes[string_index+1] as usize] {
                string_index += patlen + 1;  // sunday
            } else {
                string_index += self.bm_bc[string_bytes[string_index] as usize];  // horspool
            }
        }

        result
    }
}

這個版本的 B5S 性能表現非常理想,是通常情況下,目前介紹的後綴匹配系列算法中最快的。

空間節省版本

這也是 CPython stringlib 中實現的版本,使用了兩個整數近似取代了字符表和 \(delta_1\) 的作用,極大地節省了空間:

用一個簡單的 Bloom 過濾器取代字符表(alphabet)
實現
1
2
3
pub struct BytesBloomFilter {
    mask: u64,
}

impl BytesBloomFilter {pub fn new() -> Self { SimpleBloomFilter { mask: 0, } }

1
2
3
4
5
6
7
fn insert(&mut self, byte: &u8) {
    (self.mask) |= 1u64 << (byte & 63);
}

fn contains(&self, char: &u8) -> bool {
    (self.mask & (1u64 << (byte & 63))) != 0
}

}

1

Bloom 過濾器設設計通過犧牲準確率(實際還有運行時間)來極大地節省存儲空間的 Set 類型的數據結構,它的特點是會將集合中不存在的項誤判為存在(False Positives,簡稱 FP),但不會把集合中存在的項判斷為不存在(False Negatives,簡稱 FN),因此使用它可能會因為 FP 而沒有得到最大的字符跳轉,但不會因為 FN 而跳過本應匹配的字符。

理論上分析,上述「Bloom 過濾器」的實現在 \(pat\) 長度在 50 個 Bytes 時,FP 概率約為 0.5,而 \(pat\) 長度在 10 個 Bytes 時,FP 概率約為 0.15。

當然這不是一個標準的 Bloom 過濾器,首先它實際上沒有使用一個真正的哈希函數,實際上它只是一個字符映射,就是將 0-255 的字節映射為它的前六位構成的數,考慮到我們在做內存上的字符搜索,這樣的簡化就非常重要,因為即使用目前已知最快的非加密哈希算法 xxHash,計算所需要的時間都要比它高一個數量級。

另外,按照計算,當 pat 在 30 字節以下時,為了達到最佳的 FP 概率,需要超過一個哈希函數,但這麼做意義不大,因為用裝有兩個 u128 數字的數組就已經可以構建字符表的全字符集。

使用 \(delta_1(pat[patlastpos])\) 代替整個 \(delta_1\)

觀察 \(delta_1\) 最常使用的地方就是後綴匹配時第一個字符就不匹配是最常見的不匹配的情況,於是令 skip = delta1(pat[patlastpos]),

在第一階段不匹配時,直接向下滑動 skip 個字符;但當第二階段不配時,因為缺乏整個 \(delta_1\) 的信息,只能向下滑動一個字符。

實現
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
pub struct B5SSpacePattern<'a> {
    pat_bytes: &'a [u8],
    alphabet: BytesBloomFilter,
    skip: usize,
}

impl<'a> B5SSpacePattern<'a> {
    pub fn new(pat: &'a str) -> Self {
        assert_ne!(pat.len(), 0);

        let pat_bytes = pat.as_bytes();
        let (alphabet, skip) = B5SSpacePattern::build(pat_bytes);

        B5SSpacePattern { pat_bytes, alphabet, skip}
    }

    fn build(p: &'a [u8]) -> (BytesBloomFilter, usize)  {
        let mut alphabet = BytesBloomFilter::new();
        let lastpos = p.len() - 1;
        let mut skip = p.len();

        for i in 0..p.len()-1 {
            alphabet.insert(&p[i]);

            if p[i] == p[lastpos] {
                skip = lastpos - i;
            }
        }

        alphabet.insert(&p[lastpos]);

        (alphabet, skip)
    }

    pub fn find_all(&self, string: &'a str) -> Vec<usize> {
        let mut result = vec![];
        let string_bytes = string.as_bytes();
        let pat_last_pos = self.pat_bytes.len() - 1;
        let patlen = self.pat_bytes.len();
        let stringlen = string_bytes.len();
        let mut string_index = pat_last_pos;

        while string_index < stringlen {
            if string_bytes[string_index] == self.pat_bytes[pat_last_pos] {
                if &string_bytes[string_index-pat_last_pos..string_index] == &self.pat_bytes[..patlen-1] {
                    result.push(string_index-pat_last_pos);
                }

                if string_index + 1 == stringlen {
                    break;
                }

                if !self.alphabet.contains(&string_bytes[string_index+1]) {
                    string_index += patlen + 1;  // sunday
                } else {
                    string_index += self.skip;  // horspool
                }
            } else {
                if string_index + 1 == stringlen {
                    break;
                }

                if !self.alphabet.contains(&string_bytes[string_index+1]) {
                    string_index += patlen + 1;  // sunday
                } else {
                    string_index += 1;
                }
            }

        }

        result
    }
}

這個版本的算法相對於前面的後綴匹配算法不夠快,但差距並不大,仍然比 KMP 這種快得多,特別是考慮到它極為優秀的空間複雜度:至多兩個 u64 的整數,這確實是極為實用的適合作為標準庫實現的一種算法!

理論分析

現在我們通過一個簡單的概率模型來做一些絕不枯燥的理論上的分析,藉此可以發現一些有趣而更深入的事實。

建立模型

想象一下,我們滑動字符串 \(pat\) 到某個新的位置,這個位置還沒有完成匹配,我們可以用發現失配所需要的代價與發現失配後 \(pat\) 能夠向下滑動的字符數的比值來衡量算法的平均性能表現。

假如這個代價是用對 \(string\) 的引用來衡量,那麼我們就可以知道平均每個字符需要多少次 \(string\) 的引用,這是在理論上衡量算法表現的關鍵指標;

而如果這個代價是用機器指令衡量,那我們可以知道平均每個字符需要多少條機器指令;

當然也可以有其他的衡量方式,這並不影響什麼,這裏我們採用對 \(string\) 的引用進行理論分析。

同時為我們的概率模型提出一個假設:\(pat\),\(string\) 中的每個字符是獨立隨機變量,它們出現的概率相等,為 \(p\),\(p\) 取決於全字母表的大小。

顯然,假如全字母表的大小為 \(q\),則 \(p=\dfrac{1}{q}\),例如假設我們之前基於字節的實現,在日常一般搜索時,可以近似為 \(q=\dfrac{1}{256}\)。

現在可以更準確地刻畫這個比率,\(rate(patlen, p)\):

\[ \frac{\sum_{m=0}^{patlen-1} cost(m) \times prob(m)}{\sum_{m=0}^{patlen-1}prob(m) \times \sum_{k=1}^{patlen}skip(m,k) \times k } \]

其中,\(cost(m)\) 為前面討論到的在匹配成功了 \(m\) 個字符後失配時的代價:

\[ cost(m) = m+1 \]

\(prob(m)\) 為匹配成功 \(m\) 個字符後失配的概率(其中 \(1-p^{patlen}\) 排除掉 \(pat\) 全部匹配的情況):

\[ prob(m) = \frac{p^m(1-p)}{1-p^{patlen}} \]

\(skip(m,k)\) 為發生失配時 \(pat\) 向下滑動 \(k\) 個字符的概率,(這裏的 \(k\) 如同前文討論的 \(k\) 一樣,為 \(pat\) 實際滑動距離,不包括指針從失配位置回退到 \(patlastpos\) 位置的距離)。實際上所有字符串匹配算法的核就在於 \(skip(m,k)\),下面我們會通過分析 \(delta_1\) 和 \(delta_2\) 來計算 BoyerMoore 算法的 \(skip(m,k)\)。

計算 BoyerMoore 算法的 \(skip(m,k)\)

\(delta_1\)

首先考慮 \(delta_1\) 不起作用的情況,也就是發現失配字符在 \(pat\) 上重現的位置在已經匹配完的 \(m\) 個字符中,這種情況的概率 \(\textit{probdelta_1_worthless}\) 為:

\[ \textit{probdelta1_worthless}(m) = 1 - (1-p)^m \]

而對於 \(delta_1\) 起作用的情況,可以根據 k 的範圍分為四種情況進行討論:

  1. 當 \(k = 1\) 時:

    1. 失配字符對應位置的下一個字符恰好等於失配字符;

    2. 失配字符已經是 \(pat\) 右手起最後一個字符。

  2. 當 \(1 < k < patlen-m\) 時,\(pat\) 在失配字符對應位置的左邊還有與失配字符相等的字符,並且不滿足情況 1;

  3. 當 \(k = patlen - m\) 時,\(pat\) 在失配字符對應位置左邊找不到另一個與失配字符相等的字符,並且不滿足情況 1,這時 \(pat\) 有最大可能的向下滑動距離;

  4. 當 \(k > patlen - m\) 時,顯然對於 \(delta_1\),這是不可能存在的情況。

於是有計算 \(delta_1\) 的概率函數:

\[ probdelta1(m,k) = \begin{cases}{lcl} (1-p)^m\times \begin{cases}{lcl} 1 & \text{for}~m+1=patlen \\ p &\text{for}~m+1\neq patlen \\\end{cases} & \text{for}~ k = 1 \\ (1-p)^{m+k-1}\times p & \text{for}~ 1 < k < patlen - m\\ (1-p)^{patlen-1} & \text{for}~ k = patlen - m\\ 0 & \text{for}~ patlen patlen - m < k \leqslant patlen \end{cases} \]

\(delta_2\)

對於 \(delta_2\) 概率的計算,根據定義,首先計算某個 \(subpat\) 的重現的概率,只要考慮該重現左邊還有沒有字符來提供額外的判斷與失配字符是否相等的檢查:

\[ probpr(m,k) = \begin{cases}{lcl} (1-p)\times p^m & \text{for}~ 1 \leqslant k < patlen - m\\ p^{patlen-k} & \text{for}~ patlen - m \leqslant k \leqslant patlen \end{cases} \]

於是 \(delta_2(m,k)\) 就可以通過保證 \(pr(m,k)\) 存在並且 \(k\) 更小的 \(delta_2\) 不存在,來遞歸計算:

\[ probdelta2(m,k) = probpr(m,k)(1-\sum_{n=1}^{k-1}probdelta2(m, n)) \]

彙總

前面已經獨立討論了 \(delta_1\),\(delta_2\) 的概率函數,不過還需要額外考慮一下這兩個概率函數之間相互影響的情況,雖然只是一個很少數的情況:

當 \(delta_2\) 計算的 \(k\) 為 1 的時候,根據 \(delta_2\) 定義我們就知道 \(pat[-(m+1)] = pat[-m]=pat[-(m-1)]\dots pat[-1]\),(\(pat[-n]\) 表示 \(pat\) 的倒數第 \(n\) 個字符,下同)。而這種情況已經排除了 \(delta_1\) 不起作用的情況,因為當如前文討論的,\(delta_1\) 不起作用要求與失配字符 \(pat[-(m+1)]\) 相等的字符出現在 \(pat[-m]\dots pat[-1]\) 中,這就產生了不可能在倒數 \(m+1\) 個字符上失配的矛盾。

因此針對 \(delta_1\) 不起作用的情況需要一個稍微修改過的 \(delta_2\) 概率函數:

\[ probdelta2'(m,k) = \begin{cases} 0 & \text{for}~ k = 1\\ probpr(m,k)\left(1-\sum_{n=2}^{k-1}probdelta2'(m, n)\right) & \text{for}~ 1 \leqslant k \leqslant patlen \end{cases} \]

於是通過組合 \(delta_1\) 和 \(delta_2\) 起作用的情況,我們就得到了 BoyerMoore 算法的 \(skip\) 概率函數:

\[ skip(m,k) = \begin{cases} probdelta1(m, 1) \times probdelta2(m, 1) & \text{for}~k = 1\\ \textit{prodelta1\_worthless}(m) \times probdelta2'(m, 1)\\ +~probdelta1(m, k) \times \sum_{n=1}^{k-1} probdelta2(m, n)\\ +~probdelta2(m, k) \times \sum_{n=1}^{k-1} probdelta1(m,n)\\ +~probdelta1(m, k) \times probdelta2(m, k) & \text{for}~1 < k \leqslant patlen \end{cases} \]

分析比較

為了結構清晰、書寫簡單、演示方便,我們使用 Python 平台的 Lisp 方言 Hy 來進行實際計算:

myprob.hy

 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
(require [hy.contrib.sequences [defseq seq]])

(import [hy.contrib.sequences [Sequence end-sequence]])
(import [hy.models [HySymbol]])


(defmacro simplify-probfn [patlen p probfn-list]
    "(prob-xxx patlen p m k) -> (prob-xxx-s m k)"
    (lfor probfn probfn-list
        [(setv simplified-probfn-symbol (HySymbol (.format "{}-s" (name probfn))))
        `(defn ~simplified-probfn-symbol [&rest args] (~probfn patlen p #*args))]))


(defn map-sum [range-args func]
    (setv [start end] range-args)
    (-> func (map (range start (inc end))) sum))


(defn cost [m] (+ m 1))


(defn prob-m [patlen p m]
    (/
        (* (** p m) (- 1 p))
        (- 1 (** p patlen))))


(defn prob-delta1 [patlen p m k]
    (cond [(= 1 k) (* (** (- 1 p) m)
                      (if (= (inc m) patlen) 1 p))]
          [(< k (- patlen m)) (* p (** (- 1 p) (dec (+ k m))))]
          [(= k (- patlen m)) (** (- 1 p) (dec patlen))]
          [(> k (- patlen m)) 0]))


(defn prob-delta1-worthless [p m] (- 1 (** (- 1 p) m)))


(defn prob-pr [patlen p m k] (if (< patlen (+ m k))
                                (* (- 1 p) (** p m))
                                (** p (- patlen k))))


(defn prob-delta2 [patlen p m]
    "prob-delta2(_, k) = prob-delta2-seq[k]"
    (defseq prob-delta2-seq [n]
        (cond [(< n 1) 0]
              [(= n 1) (prob-pr patlen p m 1)]
              [(> n 1) (* (prob-pr patlen p m n) (- 1 (sum (take n prob-delta2-seq))))]))
    prob-delta2-seq)


(defn prob-delta2-1 [patlen p m]
    (defseq prob-delta2-1-seq [n]
        (cond [(< n 2) 0]
              [(>= n 2) (* (prob-pr patlen p m n) (- 1 (sum (take n prob-delta2-1-seq))))]))
    prob-delta2-1-seq)


(defn skip [patlen p m k prob-delta2-seq prob-delta2-1-seq]
    (simplify-probfn patlen p [prob-delta1])
    (if (= k 1) (* (prob-delta1-s m 1) (get prob-delta2-seq 1))
        (sum [(* (prob-delta1-worthless p m) (get prob-delta2-1-seq k))
              (* (prob-delta1-s m k) (sum (take k prob-delta2-seq)))
              (* (get prob-delta2-seq k) (map-sum [1 (- k 1)]
                                                  (fn [n] (prob-delta1-s m n))))
              (* (prob-delta1-s m k) (get prob-delta2-seq k))])))


(defn bm-rate [patlen p]
    (simplify-probfn patlen p [prob-m prob-delta2 prob-delta2-1 skip])
    (/
        (map-sum [0 (dec patlen)]
            (fn [m] (* (cost m) (prob-m-s m))))

        (map-sum [0 (dec patlen)]
            (fn [m]
                (setv prob-delta2-seq (prob-delta2-s m)
                      prob-delta2-1-seq (prob-delta2-1-s m))
                (* (prob-m-s m) (map-sum [1 patlen]
                                    (fn [k] (* k (skip-s m k prob-delta2-seq prob-delta2-1-seq)))))))))

並且為了進行比較,還額外計算了簡化 BM 算法:

myprob.hy

 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
(defn simplified-bm-skip [patlen p m k]
    (simplify-probfn patlen p [prob-delta1])
    (if (= k 1) (+ (prob-delta1-s m 1) (prob-delta1-worthless p m))
        (prob-delta1-s m k)))


(defn sbm-rate [patlen p]
    (simplify-probfn patlen p [prob-m simplified-bm-skip])
    (/
        (map-sum [0 (dec patlen)]
            (fn [m] (* (cost m) (prob-m-s m))))

        (map-sum [0 (dec patlen)]
            (fn [m] (* (prob-m-s m) (map-sum [1 patlen]
                                        (fn [k] (* k (simplified-bm-skip-s m k)))))))))

和 KMP 算法:

myprob.hy

 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
(defn getone [&rest body &kwonly [default None]]
  (try
    (get #*body)
    (except [_ [IndexError KeyError TypeError]]
      default)))


(defn prob-pi [patlen p]
    "prob-pi-s(m, l) = prob-pi-seq[m][l]"
    (defseq prob-pi-seq [n]
        (cond [(= n 0) []]
              [(= n 1) [1]]
              [(= n 2) [(- 1 p) p]]
              [(> n 2) (lfor i (range n)
                            (+
                                (* (getone prob-pi-seq (dec n) i :default 0) (- 1 p))
                                (* (get prob-pi-seq (dec n) (dec i)))))]))
    prob-pi-seq)


(defn skip [m k prob-pi-seq]
    (if (= m 0) (if (= k 1) 1 0)
        (get prob-pi-seq m (- m k))))


(defn at-least-1 [n]
    (if (< n 1) 1 n))


(defn kmp-rate [patlen p]
    (simplify-probfn patlen p [prob-m prob-pi])
    (setv prob-pi-seq (prob-pi-s))
    (/
        (map-sum [0 (dec patlen)]
            (fn [m] (* (cost m) (prob-m-s m))))

        (map-sum [0 (dec patlen)]
            (fn [m] (* (prob-m-s m) (map-sum [1 (at-least-1 (dec m))]
                                        (fn [k] (* k (skip m k prob-pi-seq)))))))))

然後我們就可以通過 Python 上的 plotnine 圖形包看一下計算的數據(並用高斯過程迴歸擬合曲線):

 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
import pandas as pd
from plotnine import *
import hy

from my_prob import bm_rate, sbm_rate, kmp_rate


theme_update(text=element_text(family="SimHei"))

def plot(p, title, N=30):
    model_range = range(1, N+1)
    data = {'rate':[], 'alg':[], 'patlen':[]}
    categories_list = [(bm_rate, 'BoyerMoore'),
                       (sbm_rate, 'S BoyerMoore'),
                       (kmp_rate, 'KMP'),
                       (lambda patlen, p: 1/patlen, '$\\frac{1}{patlen}$')]

    for alg_fun, label in categories_list:
        data['rate'].extend([alg_fun(patlen, p) for patlen in model_range])
        data['alg'].extend([label for _ in model_range])
        data['patlen'].extend(model_range)

    df = pd.DataFrame(data)

    return (ggplot(df, aes(x='patlen', y='rate', color='alg'))
            + geom_point()
            + geom_smooth(method='gpr')
            + labs(color='Algs', title=title, x='$patlen$', y='$\\frac{cost}{skip}$'))

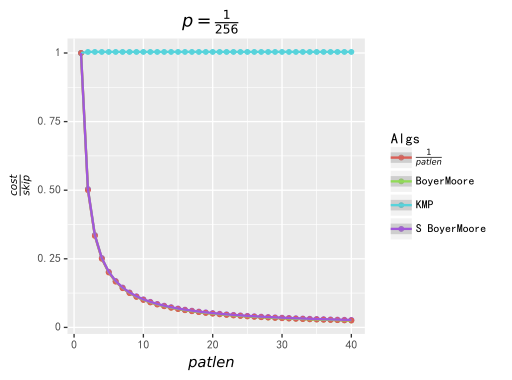
plot(1/256, '$p= \\frac{1}{256}$'):

觀察這個圖像,令人印象深刻的首先就是抬頭的一條大蘭線,幾乎筆直地畫出了算法性能的下限,不愧是 KMP 算法,\(O(n)\) 的時間複雜度,一看就很真實。

接着會發現 BoyerMoore 算法與簡化版 BoyerMoore 算法高度重疊的這條紅綠紫曲線,同時也是 \(\dfrac{1}{patlen}\),

這就是在一般字符集下隨機文本搜索能達到的 \(O(\dfrac{n}{m})\) 的強力算法嗎?

另外此時可以絕大多數的字符跳轉依靠 \(delta_1\)(比 \(delta_2\) 高几個數量),這也是基於 \(delta_1\) 表的 BM 變種算法最佳的應用場景!

接着我們可以看一下在經典的小字符集,比如在 DNA {A, C, T, G} 鹼基對序列中算法的性能表現(plot(1/4, '$p= \\frac{1}{4}$')):
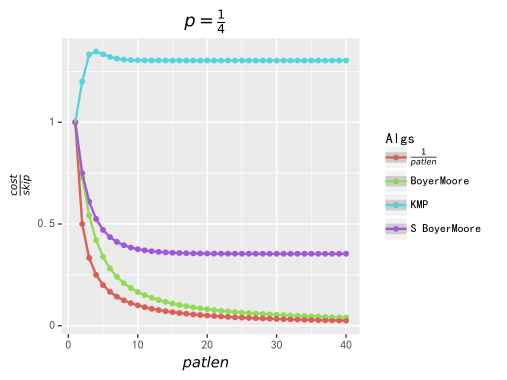
曲線出現了明顯的分化,當然 KMP 還是一如既往地穩定,如果此時在測試中監控一下一下 \(delta_1\) 表和 \(delta_2\) 表作用情況會發現:\(delta_2\) 起作用的次數超過了 \(delta_1\),而且 \(delta_2\) 貢獻的跳過字符數更是遠超 \(delta_1\),思考下,這件事其實也很好理解。

總結一下,通過概率模型的計算,一方面看到了在較大的字符集,比如日常搜索的過程中 BoyerMoore 系列算法的優越表現,其中主要依賴 \(delta_1\) 表實現字符跳轉;另一方面,在較小的字符集裏,\(delta_1\) 的作用下降,而 \(delta_2\) 的作用得到了體現。如果有一定富裕空間的情況下,使用完整的空間複雜度為 \(O(m)\) 的 BoyerMoore 算法應該是一種適用各種情況、綜合表現都很優異的算法選擇。

引用